Par Baruh Polis, MD, PhD, TECH (Technion – Institut israélien de technologie)
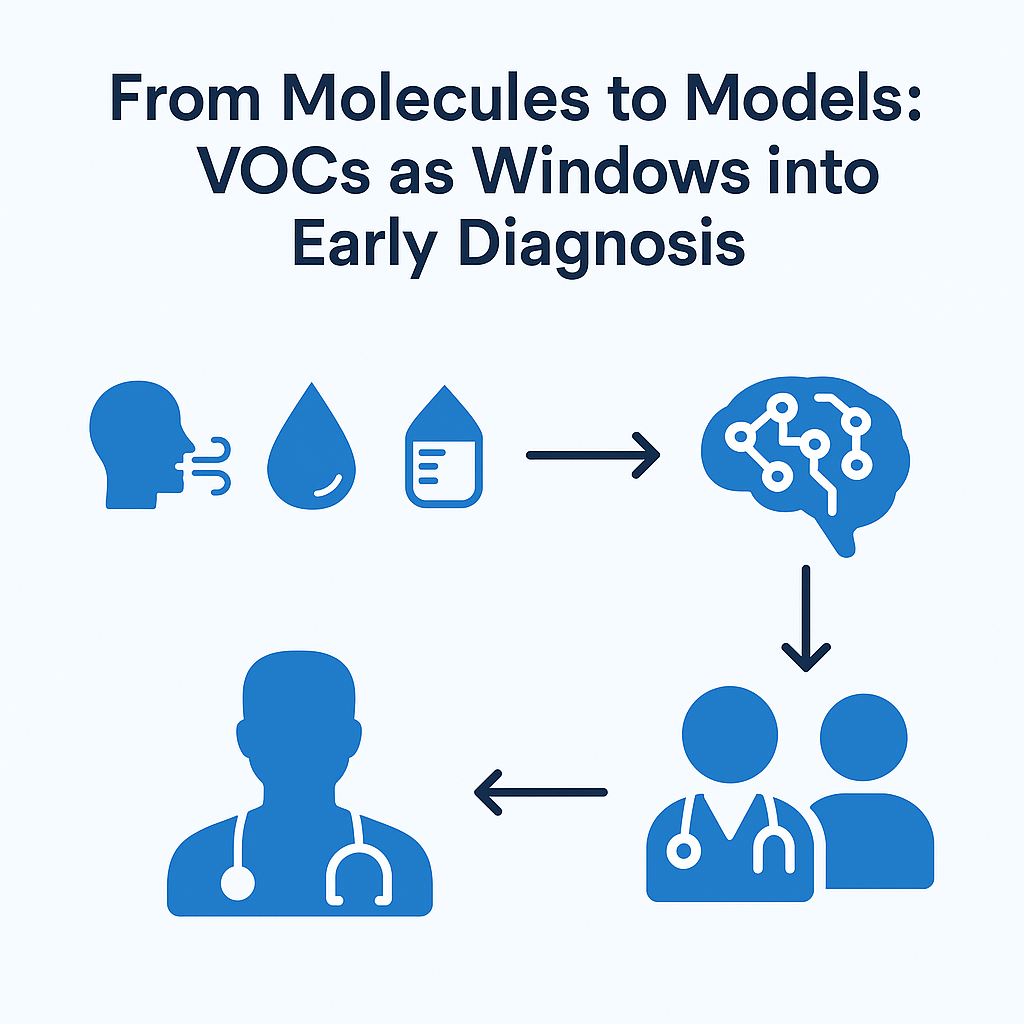
La médecine commence souvent par des questions d'une simplicité trompeuse : Qu'est-ce qui ne va pas ? Pouvons-nous le savoir plus tôt ? Comment pouvons-nous aider ? Derrière tout cela se cachent des siècles de lutte, à la fois scientifique et humaine. Le projet VOLABIOS porte cette tradition vers une nouvelle frontière : utiliser des composés organiques volatils (COV) — provenant de l'haleine, de la sueur, du sang et de l'urine — pour faciliter la détection précoce et la gestion de la schizophrénie.
Pour VOLABIOS, un système d'aide à la décision clinique (CDSS) est central. Mais un CDSS ne peut pas être construit à partir de la seule intuition. Cela nécessite une traduction : transformer les questions cliniques en tâches que l'apprentissage automatique peut gérer.
De la question clinique à la tâche d'apprentissage automatique
Les cliniciens ont posé trois questions urgentes :
- Pouvons-nous identifier les personnes à haut risque avant l'apparition complète de la maladie ?
- Pouvons-nous distinguer la schizophrénie d'un trouble dépressif majeur ou d'un trouble bipolaire ?
- Pouvons-nous anticiper les rechutes et surveiller la progression de la maladie ?
Pour l'IA, cela devient des problèmes techniques. Le diagnostic précoce est une classification binaire : « schizophrénie probable » vs « pas de schizophrénie ». La différenciation des psychoses affectives et non affectives devient une classification multi-classe. La prédiction des rechutes devient un modèle de temps jusqu'à l'événement, dans lequel l'histoire d'un patient se déroule sous forme de données temporelles.
La traduction ici n'est pas simplement linguistique. Il remodèle les questions de la psychiatrie sous des formes mesurables et testables que les algorithmes peuvent traiter.
À quoi ressemblent les données
En clinique, un psychiatre voit une personne ; dans le CDSS, cette personne apparaît sous forme de données :
- Évaluations structurées via des échelles d'évaluation psychiatriques (PANSS, BPRS, MADRS).
- Données multi-omiques provenant du sang, de l'urine et de la salive.
- Profils de COV provenant de plusieurs fluides corporels.
- Mode de vie, données démographiques et expositions environnementales.
Chacun est une fonctionnalité dans un ensemble de données. Mais les chiffres ne sont pas la réalité elle-même : ce sont des représentations, un peu comme les mots dans le discours. Derrière chacun se cache un choix : quoi mesurer, comment le coder, comment protéger la vie privée. Certains indicateurs servent de proxy : un changement de médicament peut laisser présager une aggravation des symptômes, une réadmission à l'hôpital en cas de rechute.
Le CDSS doit donc être prudent et s'assurer que les proxys ne remplacent pas le jugement.
Comment fonctionnent les modèles
Une fois les données préparées, les modèles prennent forme :
- Régression logistique pour des classifications interprétables.
- Random Forest ou gradient boosting lors des interactions multiples.
- Réseaux de neurones pour des modèles omiques subtils.
- Modèles de séries chronologiques pour les prévisions de rechute.
Le choix reflète des compromis : transparence contre précision, interprétabilité contre complexité. Les cliniciens doivent faire confiance aux résultats. Cela signifie que les résultats ne peuvent pas rester des « boîtes noires ». Ils ont besoin de scores de risque, d'intervalles de confiance et d'explications parallèlement à des prédictions.
Il ne s'agit pas uniquement de mathématiques. Comme un jeune collègue, le CDSS doit proposer des raisons ainsi que des résultats, en fondant ses suggestions sur des preuves que les cliniciens peuvent évaluer.
En pratique
Imaginez un psychiatre à Aix-la-Chapelle ou à Haïfa avec un jeune patient dans un premier épisode psychotique. Le patient expire dans un appareil VOC. En quelques minutes, le tableau de bord du CDSS affiche :
- Score de risque : probabilité de 0,72 de schizophrénie.
- Facteurs clés : pentane et triméthylamine élevés ; antécédents familiaux.
- Incertitude : ±0,08 niveau de confiance.
Cela ne remplace pas l'expertise du clinicien. Cela l’aiguise en donnant une structure à l’incertitude, en mettant en évidence les signaux cachés et en suscitant la discussion sur les diagnostics différentiels. La traduction est circulaire : les questions cliniques ont façonné l'algorithme, et maintenant l'algorithme remodèle la rencontre clinique.
Défis à venir
Plusieurs problèmes nécessitent une attention particulière :
- Hétérogénéité des données. Les résultats des COV varient selon les appareils et les sites. La normalisation est essentielle.
- Biais. Si les ensembles de formation s'appuient principalement sur une population, les prédictions peuvent faiblir ailleurs.
- Éthique. Le consentement éclairé doit s'étendre à l'utilisation algorithmique des données personnelles.
- Réglementation. Dans le cadre du MDR/IVDR de l'UE, des preuves cliniques solides sont nécessaires avant le déploiement.
Une nouvelle imagination diagnostique
La transformation des questions psychiatriques en tâches d'apprentissage automatique modifie la compréhension de soi du domaine. Une fois que nous nous demandons si une rechute peut être prédite avec un modèle de survie, ou si les sous-types de patients peuvent être séparés avec un classificateur, nous recadrons ce que signifie savoir en psychiatrie.
VOLABIOS ne prétend pas que les COV ou les algorithmes résoudront la schizophrénie. Mais ils peuvent augmenter l’imagination diagnostique de la psychiatrie.
L’IA ne remplace pas le jugement mais une perspective supplémentaire, qui peut révéler des régularités cachées et aider les cliniciens à agir plus tôt. En reliant la psychiatrie et l'informatique, VOLABIOS crée non seulement un outil mais une nouvelle forme de collaboration entre la perspicacité humaine et l'apprentissage automatique.